Đại số tuyến tính cơ bản - Phần 1

· 26 min read
Lam Tran

Linear Algebra

Tiếp đây sẽ là loạt bài viết về đại số tuyến tính mình đã học lại khi đọc quyển Mathematics for Machine Learning trong thời gian học về Machine Learning và AI. Đây là phần thứ nhất trong loạt bài này.

Giải hệ phương trình tuyến tính​

Hệ phương trình tuyến tính là tập các phương trình tuyến tính với cùng những biến số, cấp 2 chúng ta đã giải chán chê phương trình này, thậm chí còn phải làm các hệ phương trình khó nhằn hơn chứa cả biến bậc 2, bậc 3,... Giờ đây, trở lại với đại số tuyến tính, ta có thể mô hình hệ phương trình tuyến tính bậc một với tích của ma trận và véc-tơ tương ứng. Ví dụ ta có một hệ phương trình đơn giản sau

{x1+8x3−4x4=42x2+2x3+12x4=8{ \begin{cases} x_{1} + 8x_{3} - 4x_{4} = 42 \\\\ x_{2} + 2x_{3} + 12x_{4} = 8 \end{cases} }

Sẽ được viết dưới dạng tích ma trận và véc-tơ biến số như sau

[108−401212]∗[x1x2x3x4]=[428]{ \begin{bmatrix} 1 & 0 & 8 & -4 \\\\ 0 & 1 & 2 & 12 \end{bmatrix} * \begin{bmatrix} x_{1} \\\\ x_{2} \\\\ x_{3} \\\\ x_{4} \end{bmatrix} = \begin{bmatrix} 42 \\\\ 8 \end{bmatrix} }

⇔[10]x1+[01]x2+[82]x3+[−412]x4=[428]        (1){ \Leftrightarrow \begin{bmatrix} 1 \\\\ 0 \end{bmatrix} x_{1} + \begin{bmatrix} 0 \\\\ 1 \end{bmatrix} x_{2} + \begin{bmatrix} 8 \\\\ 2 \end{bmatrix} x_{3} + \begin{bmatrix} -4 \\\\ 12 \end{bmatrix} x_{4} = \begin{bmatrix} 42 \\\\ 8 \end{bmatrix} \\\;\\\;\\\;\\\;(1) }

Nghiệm chung và nghiệm riêng của phương trình​

Nhìn vào biểu thức bên trên (1){(1)}, ta có

  • Một nghiệm riêng của hệ phương trình là [42800]T{\begin{bmatrix} 42 & 8 & 0 & 0 \end{bmatrix}^T}.
  • Để có thể thu được tất cả nghiệm thỏa mãn, ta cần phải đi giải phương trình Ax=0{\boldsymbol{Ax} = \boldsymbol{0}} nữa. Ta tiến hành phân tích phương trình (1){(1)} ra như sau

[10]x1+[01]x2+8[10]x3+2[01]x3+[−412]x4=0{ \begin{bmatrix} 1 \\\\ 0 \end{bmatrix} x_{1} + \begin{bmatrix} 0 \\\\ 1 \end{bmatrix} x_{2} + 8\begin{bmatrix} 1 \\\\ 0 \end{bmatrix} x_{3} + 2\begin{bmatrix} 0 \\\\ 1 \end{bmatrix} x_{3} + \begin{bmatrix} -4 \\\\ 12 \end{bmatrix} x_{4} = \boldsymbol{0} }

Nhìn vào phương trình trên, ta có được một nghiệm cho Ax=0{\boldsymbol{Ax} = \boldsymbol{0}} là λ1[82−10]T{\lambda_{1}\begin{bmatrix} 8 & 2 & -1 & 0 \end{bmatrix}^T}. Tương tự như trên, ta tìm thêm được một nghiệm cho Ax=0{\boldsymbol{Ax} = \boldsymbol{0}} nữa là λ2[−4120−1]T{\lambda_{2}\begin{bmatrix} -4 & 12 & 0 & -1 \end{bmatrix}^T}. Phương trình Ax=0{\boldsymbol{Ax} = \boldsymbol{0}} chỉ có 2 nghiệm, tại sao lại như vậy thì bên dưới mình sẽ nói sau. Như vậy, hệ phương trình có nghiệm chung là

x∈R4:x=[42800]+λ1[82−10]+λ2[−4120−1],λ1,λ2∈R{ \\{ x \in \Bbb R^4: x = \begin{bmatrix} 42 \\\\ 8 \\\\ 0 \\\\ 0 \end{bmatrix} + \lambda_{1}\begin{bmatrix} 8 \\\\ 2 \\\\ -1 \\\\ 0 \end{bmatrix} + \lambda_{2}\begin{bmatrix} -4 \\\\ 12 \\\\ 0 \\\\ -1 \end{bmatrix}, \lambda_{1}, \lambda_{2} \in \Bbb R \\} }

Biến đổi ma trận​

Ví dụ​

Mình sẽ đem một ví dụ cho phương pháp này

{−2x1+4x2−2x3−x4+4x5=−34x1−8x2+3x3−3x4+x5=2x1−2x2+x3−x4+x5=0x1−2x2−3x4+x5=a{ \begin{cases} -2x_{1} + 4x_{2} - 2x_{3} - x_{4} + 4x_{5} = -3 \\\\ 4x_{1} - 8x_{2} + 3x_{3} - 3x_{4} + x_{5} = 2 \\\\ x_{1} - 2x_{2} + x_{3} - x_{4} + x_{5} = 0 \\\\ x_{1} - 2x_{2} - 3x_{4} + x_{5} = a \\\\ \end{cases} }

Viết thành dạng

[−24−2−144−83−311−21−111−20−31∣−320a]{ \left[ \begin{matrix} -2 & 4 & -2 & -1 & 4 \\\\ 4 & -8 & 3 & -3 & 1 \\\\ 1 & -2 & 1 & -1 & 1 \\\\ 1 & -2 & 0 & -3 & 1 \\\\ \end{matrix} \left| \begin{matrix} -3 \\\\ 2 \\\\ 0 \\\\ a \\\\ \end{matrix} \right. \right] }

⇝...⇝[1−21−11001−130001−200000∣0−21a+1]{ \rightsquigarrow ... \rightsquigarrow \left[ \begin{matrix} 1 & -2 & 1 & -1 & 1 \\\\ 0 & 0 & 1 & -1 & 3 \\\\ 0 & 0 & 0 & 1 & -2 \\\\ 0 & 0 & 0 & 0 & 0 \\\\ \end{matrix} \left| \begin{matrix} 0 \\\\ -2 \\\\ 1 \\\\ a+1 \\\\ \end{matrix} \right. \right] }

Do vậy, hệ phương trình được giải khi a=−1{a = -1}.

  • Nghiệm riêng của phương trình là [20−110]T{\begin{bmatrix} 2 & 0 & -1 & 1 & 0 \end{bmatrix}^T}.
  • Nghiệm của phương trình Ax=0{\boldsymbol{Ax} = \boldsymbol{0}} là λ1[21000]T{\lambda_{1}\begin{bmatrix} 2 & 1 & 0 & 0 & 0 \end{bmatrix}^T} và λ2[−201−2−1]T{\lambda_{2}\begin{bmatrix} -2 & 0 & 1 & -2 & -1 \end{bmatrix}^T}.

Như vậy, nghiệm chung của phương trình là

x∈R5:x=[20−110]+λ1[21000]+λ2[−201−2−1],λ1,λ2∈R{ \\{ x \in \Bbb R^5: x = \begin{bmatrix} 2 \\\\ 0 \\\\ -1 \\\\ 1 \\\\ 0 \end{bmatrix} + \lambda_{1}\begin{bmatrix} 2 \\\\ 1 \\\\ 0 \\\\ 0 \\\\ 0 \end{bmatrix} + \lambda_{2}\begin{bmatrix} -2 \\\\ 0 \\\\ 1 \\\\ -2 \\\\ -1 \end{bmatrix}, \lambda_{1}, \lambda_{2} \in \Bbb R \\} }

Ma trận bậc thang​

Một ma trận ở dạng bậc thang nếu

  • Những hàng chỉ chứa 0 sẽ ở đáy ma trận. Những hàng chứa ít nhất 1 số khác không sẽ nằm trên các hàng chứa toàn 0.
  • Các phần tử pivot của mỗi hàng luôn ở phía bên phải của các phần tử pivot ở các hàng bên trên.

Các biến ứng với các phần tử pivot là các basic variables, các biến còn lại là free variables. Do vậy mà ở Mục 1.1 phương trình Ax=0{\boldsymbol{Ax} = \boldsymbol{0}} chỉ có hai nghiệm, tại chỉ có 2 biến là free variables (tức là các biến ứng với các phần tử không là phần tử pivot).

Với hệ phương trình tuyến tính Ax=b{\boldsymbol{Ax} = \boldsymbol{b}}, để tính toán một nghiệm riêng, ta biểu diễn các b=∑i=1pλipi{\boldsymbol{b} = \sum_{i = 1}^p \lambda_{i}\boldsymbol{p_{i}}} với pi{\boldsymbol{p_{i}}} là các pivot columns, chúng ta thường bắt đầu ước lượng các giá trị λi{\lambda_{i}} với các pivot columns từ phải sang trái.

Một ma trận ở dạng bậc thang tối giản nếu

  • Nó là một ma trận bậc thang.
  • Các phần tử pivot đều bằng 1.
  • Phần tử pivot là phần tử duy nhất khác 0 tại pivot column đó.

Việc tính toán nghiệm Ax=0{\boldsymbol{Ax} = \boldsymbol{0}} sẽ dễ dàng hơn rất nhiều nếu ma trận biểu diễn hệ phương trình tuyến tính ở dạng bậc thang tối giản

Phép khử Gaussian​

Là một thuật toán biểu diễn các phép biến đổi triệt tiêu giữa các hàng để đưa ma trận biểu diễn hệ phương trình tuyến tính về dạng ma trận bậc thang tối giản.

Để tính toán nghiệm của Ax=0{\boldsymbol{Ax} = \boldsymbol{0}} trong ma trận bậc thang tối giản, ta biểu diễn các pivot column bằng tổng các cấp số của các pivot columns ở bên trái của chúng.

Ví dụ với ma trận bậc thang sau

A=[130−40001−300000100000]{ \boldsymbol{A} = \begin{bmatrix} 1 & 3 & 0 & -4 & 0 \\\\ 0 & 0 & 1 & -3 & 0 \\\\ 0 & 0 & 0 & 0 & 1 \\\\ 0 & 0 & 0 & 0 & 0 \\\\ \end{bmatrix} }

Nghiệm của phương trình Ax=0{\boldsymbol{Ax} = \boldsymbol{0}} là

x∈R5:x=λ1[3−1000]+λ2[−40−3−10],λ1,λ2∈R{ \\{ x \in \Bbb R^5: x = \lambda_{1}\begin{bmatrix} 3 \\\\ -1 \\\\ 0 \\\\ 0 \\\\ 0 \end{bmatrix} + \lambda_{2}\begin{bmatrix} -4 \\\\ 0 \\\\ -3 \\\\ -1 \\\\ 0 \end{bmatrix}, \lambda_{1}, \lambda_{2} \in \Bbb R \\} }

The -1 trick​

Với ma trận A{\boldsymbol{A}} ở trên, ta sẽ chêm các hàng gồm toàn 0{0} và chỉ một số −1{-1} vào giữa các hàng của ma trận bậc thang tối giản, để tạo nên ma trận mới có đường chéo chính gồm toàn −1{-1} và 1{1} như dưới đây.

A⇝[130−400−1000001−30000−1000001]{ \boldsymbol{A} \rightsquigarrow \begin{bmatrix} 1 & 3 & 0 & -4 & 0 \\\\ 0 & -1 & 0 & 0 & 0 \\\\ 0 & 0 & 1 & -3 & 0 \\\\ 0 & 0 & 0 & -1 & 0 \\\\ 0 & 0 & 0 & 0 & 1 \\\\ \end{bmatrix} }

Từ đó, các cột chứa giá trị −1{-1} tại các vị trí trên đường chéo chính của ma trận sẽ là nghiệm của phương trình Ax=0{\boldsymbol{Ax} = \boldsymbol{0}}.

Một số thuật toán để giải hệ phương trình này​

Có một số thuật toán thông dụng để giải hệ phương trình tuyến tính phức tạp

  • Sử dụng thuật toán hồi quy tuyến tính (linear regression), thuật toán này thường áp dụng vào các bài toán mà ta chỉ có thể tính xấp xỉ nghiệm của phương trình.
  • Normal equation, thuật toán này tính chính xác nghiệm của hệ phương trình, nhưng số lượng tính toán rất nhiều nên không thể sử dụng với các trường hợp số lượng biến nhiều. Phương pháp này được thể hiện dưới đây

Ax=b⇔ATAx=ATb⇔x=(ATA)−1ATb{ \boldsymbol{Ax} = \boldsymbol{b} \Leftrightarrow \boldsymbol{A^TAx} = \boldsymbol{A^Tb} \Leftrightarrow \boldsymbol{x} = \boldsymbol{(A^TA)^{-1}A^Tb} }

Việc phải nhân ma trận và tính toán nghịch đảo khiến phương pháp này có độ phức tập là Θ(n3){\Theta(n^3)}.

Không gian véc-tơ​

Nhóm​

Cho một tập G{\mathcal{G}} với phép toán ⊗:G×G→G{\otimes: \mathcal{G} \times \mathcal{G} \to \mathcal{G}} được định nghĩa trên G{\mathcal{G}} thì G:=(G,⊗){\mathcal{G} := (\mathcal{G}, \otimes)} được gọi là một nhóm nếu thỏa mãn các tính chất

  • Tính đóng gói của G{\mathcal{G}} trong phép ⊗{\otimes}: ∀x,y∈G{\forall x, y \in \mathcal{G}} thì x⊗y∈G{x \otimes y \in \mathcal{G}}.
  • Tính kết hợp: ∀x,y,z∈G{\forall x, y, z \in \mathcal{G}} thì (x⊗y)⊗z=x⊗(y⊗z){(x \otimes y) \otimes z = x \otimes (y \otimes z)}.
  • Tồn tại phần tử đơn vị: ∃e∈G,∀x∈G{\exists e \in \mathcal{G}, \forall x \in \mathcal{G}} thỏa mãn x⊗e=x{x \otimes e = x} và e⊗x=x{e \otimes x = x}.
  • Tồn tại phần tử nghịch đảo: ∀x∈G,∃y∈G{\forall x \in \mathcal{G}, \exists y \in \mathcal{G}} thỏa mãn x⊗y=e{x \otimes y = e} và y⊗x=e{y \otimes x = e}.

Nếu nhóm có thêm tính chất giao hoán ∀x,y∈G:x⊗y=y⊗x{\forall x, y \in \mathcal{G}: x \otimes y = y \otimes x} thì nhóm đó được gọi là nhóm Abelian.

Một nhóm các ma trận khả nghịch A∈Rn×n{A \in \Bbb R^{n \times n}} với phép toán nhân ma trận được gọi là một General Linear Group. Tuy nhiên, phép nhân ma trận không có tính chất giao hoán nên nhóm này không phải là một nhóm Abelian.

Không gian véc-tơ​

Một không gian véc-tơ thực V=(V,+,⋅){V = (\mathcal{V}, + , \cdot)} là một tập V{V} với 2 phép toán

+:V×V→V{ +: \mathcal{V} \times \mathcal{V} \to \mathcal{V} }

⋅:R×V→V{ \cdot: \Bbb R \times \mathcal{V} \to \mathcal{V} }

Thỏa mãn

  • V,+{\mathcal{V}, +} là một nhóm Abelian.
  • Tính chất phân phối ∀λ∈R,x,y∈V:λ⋅(x+y)=λ⋅x+λ⋅y{\forall \lambda \in \Bbb R, x, y \in \mathcal{V}: \lambda \cdot(x + y) = \lambda \cdot x + \lambda \cdot y} và ∀λ,ψ∈R,x∈V:(λ+ψ)⋅x=λ⋅x+ψ⋅x{\forall \lambda, \psi \in \Bbb R, x \in \mathcal{V}: (\lambda + \psi)\cdot x = \lambda \cdot x + \psi \cdot x}
  • Tính chất kết hơp ∀λ,ψ∈R,x∈V:λ⋅(ψ⋅x)=(λ⋅ψ)⋅x{\forall \lambda, \psi \in \Bbb R, x \in \mathcal{V}: \lambda \cdot(\psi \cdot x) = (\lambda \cdot \psi)\cdot x}
  • Tồn tại phần tử đơn vị ∀x∈V:1⋅x=x{\forall x \in \mathcal{V}: 1 \cdot x = x}

Không gian véc-tơ con​

Với V=(V,+,⋅){V = (\mathcal{V}, + , \cdot)} là một không gian véc-tơ và U⊆V,U≠∅{\mathcal{U} \subseteq \mathcal{V}, \mathcal{U} \ne \emptyset} thì U=(U,+,⋅){U = (\mathcal{U}, + , \cdot)} được gọi là không gian véc-tơ con của V{V} nếu U{U} là một không gian véc-tơ cùng với các phép toán +{+} và ⋅{\cdot} ứng với U×U{\mathcal{U} \times \mathcal{U}} và R×U{\Bbb R \times \mathcal{U}}. Kí hiệu U⊆V{U \subseteq V} thể hiện U{U} là một không gian véc-tơ con của V{V}.

Nếu U{U} là một không gian véc-tơ con của V{V}, U{U} sẽ thừa hưởng tất cả các tính chất của V{V}. Để chứng minh U{U} là một không gian véc-tơ con của V{V}, chúng ta vẫn phải chỉ ra được

  • U≠∅{\mathcal{U} \ne \emptyset} hay 0∈U{0 \in \mathcal{U}}.
  • Tính đóng gói của U{U}: ∀λ∈R,∀x∈U:λx∈U{\forall \lambda \in \Bbb R, \forall x \in \mathcal{U}: \lambda x \in \mathcal{U}} và ∀x,y∈U:x+y∈U{\forall x, y \in \mathcal{U}: x + y \in \mathcal{U}}.

Phụ thuộc tuyến tính​

Tổ hợp tuyến tính​

Cho một không gian véc-tơ V{V} và một số hữu hạn các véc-tơ x1,x2,...,xk∈V{\boldsymbol{x_{1}}, \boldsymbol{x_{2}},..., \boldsymbol{x_{k}} \in V}, mỗi v∈V{\boldsymbol{v} \in V} được biểu diễn dưới dạng

v=λ1x1+λ2x2+...+λkxk=∑i=1kλixi∈V{ \boldsymbol{v} = \lambda_{1}\boldsymbol{x_{1}} + \lambda_{2}\boldsymbol{x_{2}} + ... + \lambda_{k}\boldsymbol{x_{k}} = \sum_{i=1}^{k} \lambda_{i}\boldsymbol{x_{i}} \in V }

với λ1,λ2,...,λk∈R{\lambda_{1}, \lambda_{2},..., \lambda_{k} \in \Bbb R}, là một tổ hợp tuyến tính của các véc-tơ x1,x2,...,xk{\boldsymbol{x_{1}}, \boldsymbol{x_{2}},..., \boldsymbol{x_{k}}}.

Véc-tơ 0{\boldsymbol{0}} có thể được viết dưới dạng 0=∑i=1k0xi{\boldsymbol{0} = \sum_{i=1}^{k}0\boldsymbol{x_{i}}} nhưng chúng ta quan tâm nhiều hơn đến các tổ hợp tuyến tính không tầm thường hơn.

Phụ thuộc tuyến tính​

Nếu có một tổ hợp tuyến tính không tầm thường thỏa mãn 0=∑i=1k=λixi{0 = \sum_{i=1}^{k} = \lambda_{i}\boldsymbol{x_{i}}} với ít nhất một giá trị λi≠0{\lambda_{i} \ne 0} thì các véc-tơ x1,x2,...,xk{\boldsymbol{x_{1}}, \boldsymbol{x_{2}},..., \boldsymbol{x_{k}}} được gọi là phụ thuộc tuyến tính.

Nếu mà biểu thức trên chỉ tồn tại nghiệm tầm thường λ1=λ2=...=λk=0{\lambda_{1} = \lambda_{2} = ... = \lambda_{k} = 0} thì các véc-tơ x1,x2,...,xk{\boldsymbol{x_{1}}, \boldsymbol{x_{2}},..., \boldsymbol{x_{k}}} là độc lập tuyến tính.

Một số tính chất cho các véc-tơ kiểu này là

  • k{k} véc-tơ trên hoặc là độc lập tuyến tính, hoặc là phụ thuộc tuyến tính, chứ không có loại khác.
  • Nếu ít nhất một trong số các véc-tơ x1,x2,...,xk{\boldsymbol{x_{1}}, \boldsymbol{x_{2}},..., \boldsymbol{x_{k}}} là véc-tơ 0{\boldsymbol{0}} thì chúng sẽ phụ thuộc tuyến tính. Tính chất này cũng tương đương với việc có 2 véc-tơ giống nhau trong tập k{k} véc-tơ trên.
  • Tập các véc-tơ trên là phụ thuộc tuyến tính nếu như một trong số các véc-tơ đó có thể được biểu diễn dưới dạng tổ hợp tuyến tính của các véc-tơ còn lại.
  • Ta viết tất cả véc-tơ thành các cột của một ma trận A{\boldsymbol{A}}, sau đó biểu diễn phép khử Gaussian, ta được các pivot columns sẽ độc lập tuyến tính với các véc-tơ ở bên trái của véc-tơ đó, còn các cột không phải pivot columns sẽ có thể được biểu diễn dưới dạng một tổ hợp tuyến tính của các pivot columns ở bên trái của nó. Nếu tất cả các cột đều là pivot columns thì tất cả các véc-tơ đó là độc lập tuyến tính, còn không thì chúng sẽ là phụ thuộc tuyến tính.

Cơ sở và rank​

Hệ sinh của một không gian véc-tơ​

Cho một không gian véc-tơ V=(V,+,⋅){V = (\mathcal{V}, + , \cdot)} và một tập các véc-tơ A=x1,x2,...,xk⊆V{\mathcal{A} = \\{\boldsymbol{x_{1}}, \boldsymbol{x_{2}},..., \boldsymbol{x_{k}}\\} \subseteq \mathcal{V}} . Nếu mỗi véc-tơ v∈V{\boldsymbol{v} \in \mathcal{V}} đều có thể biểu diễn là một tổ hợp tuyến tính của x1,x2,...,xk{\boldsymbol{x_{1}}, \boldsymbol{x_{2}},..., \boldsymbol{x_{k}}}, thì A{\mathcal{A}} được gọi là hệ sinh của V{V}. Tập tất cả tổ hợp tuyến tính của A{\mathcal{A}} được gọi là một span của A{\mathcal{A}}. Nếu A{\mathcal{A}} span không gian véc-tơ V{V}, chúng ta viết V=span[A]{V = span[\mathcal{A}]} hoặc V=span[x1,x2,...,xk]{V = span[\boldsymbol{x_{1}}, \boldsymbol{x_{2}},..., \boldsymbol{x_{k}}]}.

Cơ sở của một không gian véc-tơ​

Cho một không gian véc-tơ V=(V,+,⋅){V = (\mathcal{V}, + , \cdot)} và hệ sinh A⊆V{\mathcal{A} \subseteq \mathcal{V}}, A{\mathcal{A}} được gọi là hệ sinh nhỏ nhất nếu không tồn tại một hệ sinh nhỏ hơn nào khác mà A~⊊A⊆V{\tilde{\mathcal{A}} \subsetneq \mathcal{A} \subseteq \mathcal{V}} span không gian véc-tơ V{V}. Tất cả hệ sinh độc lập tuyến tính của không gian véc-tơ V{V} là nhỏ nhất và được gọi là cơ sở của V{V}.

Với V=(V,+,⋅){V = (\mathcal{V}, + , \cdot)} là một không gian véc-tơ và B⊆V{\mathcal{B} \subseteq \mathcal{V}} và B≠∅{\mathcal{B} \ne \emptyset}. Tất cả mệnh đề sau là tương đương

  • B{\mathcal{B}} là một cơ sở của V{V}.
  • B{\mathcal{B}} là hệ sinh nhỏ nhất.
  • B{\mathcal{B}} là một tập gồm số véc-tơ độc lập tuyến tính lớn nhất của V{V}.
  • Tất cả v∈V{\boldsymbol{v} \in \mathcal{V}} là một tổ hợp tuyến tính của các véc-tơ trong B{\mathcal{B}} và tất cả tổ hợp tuyến tính là duy nhất. Nếu x=∑i=1kλibi=∑i=1kψibi{\boldsymbol{x} = \sum_{i=1}^{k}\lambda_{i}b_{i} = \sum_{i=1}^{k}\psi_{i}b_{i}} thì λi=ψi{\lambda_{i} = \psi_{i}}.

Ta có ví dụ về hệ sinh chuẩn tắc của R3{\Bbb R^{3}} là

B=[100],[010],[001]{ \mathcal{B} = \\{ \begin{bmatrix} 1 \\\\ 0 \\\\ 0 \\\\ \end{bmatrix}, \begin{bmatrix} 0 \\\\ 1 \\\\ 0 \\\\ \end{bmatrix}, \begin{bmatrix} 0 \\\\ 0 \\\\ 1 \\\\ \end{bmatrix} \\} }

Một số kết luận được rút ra như sau

  • Tất cả cơ sở đều có số các phần tử bằng nhau. Số chiều của một không gian = số các hướng độc lập nhau trong không gian đó. Số chiều của một không gian véc-tơ sẽ là số véc-tơ trong hệ cơ sở của không gian véc-tơ đó dim(V{V}) = số véc-tơ trong cơ sở của nó.
  • Nếu U⊆V{U \subseteq V} là một không gian véc-tơ con của V{V}, thì dim(U{U}) ≤{\le} dim(V{V}), dim(U{U}) ={=} dim(V{V}) khi và chỉ khi U=V{U = V}.
  • Một cơ sở của không gian véc-tơ con U=span[x1,x2,...,xk]⊆Rm{U = span[\boldsymbol{x_{1}}, \boldsymbol{x_{2}},..., \boldsymbol{x_{k}}] \subseteq \Bbb R^{m}} có thể được tìm bằng cách sau
    • Viết các véc-tơ x1,x2,...,xk{\boldsymbol{x_{1}}, \boldsymbol{x_{2}},..., \boldsymbol{x_{k}}} dưới dạng một cột của một ma trận A{\boldsymbol{A}}.
    • Biến đổi A{\boldsymbol{A}} về dạng ma trận bậc thang tối giản.
    • Các véc-tơ liên kết với các pivot columns là cơ sở của không gian véc-tơ con U{U}.

Rank của một ma trận​

Hạng của một ma trận A{\boldsymbol{A}} ={=} số véc-tơ cột độc lập tuyến tính của ma trận A{\boldsymbol{A}} ={=} số véc-tơ hàng độc lập tuyến tính của ma trận A{\boldsymbol{A}} ={=} rank(A{\boldsymbol{A}}) ={=} rk(A{\boldsymbol{A}}).

Do vậy, ta có một số nhận xét sau

  • rk(A{\boldsymbol{A}}) ={=} rk(AT{\boldsymbol{A^{T}}}).
  • Các véc-tơ cột của A∈Rm×n{\boldsymbol{A \in \Bbb R^{m \times n}}} span một không gian véc-tơ U⊆Rm{U \subseteq \Bbb R^{m}} với dim(U{U}) ={=} rk(A{\boldsymbol{A}}).
  • Các véc-tơ hàng của A∈Rm×n{\boldsymbol{A \in \Bbb R^{m \times n}}} span một không gian véc-tơ W⊆Rn{W \subseteq \Bbb R^{n}} với dim(W{W}) ={=} rk(A{\boldsymbol{A}}).
  • Với mọi A∈Rn×n{\boldsymbol{A \in \Bbb R^{n \times n}}}, A{\boldsymbol{A}} là ma trận khả nghịch khi và chỉ khi rk(A{\boldsymbol{A}}) =n{= n}.
  • Hệ phương trình tuyến tính Ax=b{\boldsymbol{Ax} = \boldsymbol{b}} có nghiệm nếu rk(A{\boldsymbol{A}}) ={=} rk(A∣b{\boldsymbol{A|b}}).
  • Với A∈Rm×n{\boldsymbol{A \in \Bbb R^{m \times n}}}, không gian véc-tơ con của bộ nghiệm phương trình Ax=0{\boldsymbol{Ax} = \boldsymbol{0}} có dim =n−{= n - } rk(A{\boldsymbol{A}}).
  • Một ma trận A∈Rm×n{\boldsymbol{A \in \Bbb R^{m \times n}}} được gọi là ma trận hạng đầy đủ nếu rk(A{\boldsymbol{A}}) =min(m,n){= min(m, n)}.

Ánh xạ tuyến tính​

Hai không gian véc-tơ thực V,W{V, W}, một ánh xạ Φ:V→W{\Phi: V \to W} bảo toàn cấu trúc các không gian véc-tơ nếu

Φ(x+y)=Φ(x)+Φ(y)Φ(λx)=λΦ(x){ \Phi(x+y) = \Phi(x) + \Phi(y) \\\\ \Phi(\lambda x) = \lambda \Phi(x) }

Với tất cả x,y∈V{x, y \in V} và λ∈R{\lambda \in \Bbb R}.

Ánh xạ tuyến tính: Với các không gian véc-tơ V,W{V, W}, một ánh xạ Φ:V→W{\Phi: V \to W} được gọi là một ánh xạ tuyến tính nếu ∀x,y∈V,∀λ,ψ∈R:Φ(λx+ψy)=λΦ(x)+ψΦ(y){\forall x, y \in V, \forall \lambda, \psi \in \Bbb R: \Phi(\lambda x+ \psi y) = \lambda \Phi(x) + \psi \Phi(y)}. Ánh xạ tuyến tính có thể được biểu diễn dạng ma trận, về phần này mình sẽ nói ở dưới.

Hai không gian véc-tơ V{V} và W{W} có chiều hữu hạn được gọi là đẳng cấu khi và chỉ khi dim(V{V}) ={=} dim(W{W}). Do vậy, tồn tại một song ánh giữa 2 không gian véc-tơ cùng số chiều. Tức là, hai không gian véc-tơ có số chiều bằng nhau là hai thứ giống nhau, khi mà nó có thể được biến đổi sang nhau mà không mất mát thông tin gì.

Ta có một số tính chất của ánh xạ tuyến tính

  • Nếu ánh xạ tuyến tính Φ:V→W{\Phi: V \to W} và ψ:W→X{\psi: W \to X}, phép ánh xạ ψ∘Φ:V→X{\psi \circ \Phi: V \to X} cũng là một ánh xạ tuyến tính.
  • Nếu Φ:V→W{\Phi: V \to W} là một đẳng cấu thì Φ−1:W→V{\Phi^{-1}: W \to V} cũng là một đẳng cấu.
  • Nếu Φ:V→W{\Phi: V \to W}, ψ:V→W{\psi: V \to W} là ánh xạ tuyến tính thì Φ+ψ,λΦ{\Phi + \psi, \lambda \Phi} với λ∈R{\lambda \in \Bbb R} cũng là các ánh xạ tuyến tính.

Biểu diễn ánh xạ tuyến tính dưới dạng ma trận​

Xét một không gian véc-tơ V{V} với cơ sở là B=(b1,b2,...,bn){B = (\boldsymbol{b_{1}}, \boldsymbol{b_{2}},..., \boldsymbol{b_{n}})}. Với mọi véc-tơ x∈V{\boldsymbol{x} \in V}, ta có một tổ hợp tuyến tính duy nhất là

x=λ1b1+λ2b2+...+λnbn{ \boldsymbol{x} = \lambda_{1} \boldsymbol{b_{1}} + \lambda_{2} \boldsymbol{b_{2}} +...+ \lambda_{n} \boldsymbol{b_{n}} }

Thì λ1,λ2,...,λn{\lambda_{1}, \lambda_{2},..., \lambda_{n}} được gọi là tọa độ của x{\boldsymbol{x}} đối với cơ sở B{B}.

λ=[λ1λ2⋮λn]{\boldsymbol{\lambda} = \begin{bmatrix} \lambda_{1} \\\\ \lambda_{2} \\\\ \vdots \\\\ \lambda_{n} \\\\ \end{bmatrix} } được gói là véc-tơ tọa độ của x{\boldsymbol{x}} đối với cơ sở B{B}. Do vậy, với một véc-tơ với các cơ sở khác nhau thì sẽ có tọa độ là khác nhau.

Xét các không gian véc-tơ V{V} và W{W} với các cơ sở tương ứng là B=(b1,b2,...,bn){B = (\boldsymbol{b_{1}}, \boldsymbol{b_{2}},..., \boldsymbol{b_{n}})} và C=(c1,c2,...,cm){C = (\boldsymbol{c_{1}}, \boldsymbol{c_{2}},..., \boldsymbol{c_{m}})}và một ánh xạ tuyến tính Φ:V→W{\Phi: V \to W}. Với j∈1,2,...,n{j \in \\{1, 2,..., n\\}}

Φ(bj)=λ1jc1+λ1jc2+...+λmjcm=∑i=1mλijci{ \Phi(\boldsymbol{b_{j}}) = \lambda_{1j}\boldsymbol{c_{1}} + \lambda_{1j}\boldsymbol{c_{2}} +...+ \lambda_{mj}\boldsymbol{c_{m}} = \sum_{i=1}^{m}\lambda_{ij}\boldsymbol{c_{i}} }

là một biểu diễn duy nhất của Φ(bj){\Phi(\boldsymbol{b_{j}})} với cơ sở C{C}. Chúng ta gọi ma trận AΦ{\boldsymbol{A_{\Phi}}} kích thước m×n{m \times n} với AΦ(i,j)=λij{\boldsymbol{A_{\Phi}(i, j)} = \lambda_{ij}} là ma trận biến đổi của Φ{\Phi} ứng với cơ sở B{B} của không gian véc-tơ V{V} và cơ sở C{C} của không gian véc-tơ W{W}.

Tọa độ của Φ(bj){\Phi(\boldsymbol{b_{j}})} ứng với cơ sở C{C} của W{W} là cột thứ jth{j_{th}} của ma trận AΦ{\boldsymbol{A_{\Phi}}}.

Do đó, nếu x^{\boldsymbol{\hat{x}}} là véc-tơ tọa độ của x∈V{\boldsymbol{x} \in V} ứng với cơ sở B{B} và y^{\boldsymbol{\hat{y}}} là véc-tơ tọa độ của y=Φ(x)∈W{\boldsymbol{y} = \Phi(\boldsymbol{x}) \in W} ứng với cơ sở C{C}. Ta có

y^=AΦx^{ \boldsymbol{\hat{y}} = \boldsymbol{A_{\Phi}} \boldsymbol{\hat{x}} }

Chuyển đổi cơ sở​

Một ánh xạ tuyến tính Φ:V→W{\Phi: V \to W}, xét 2 cơ sở sau

B=(b1,b2,...,bn){B = (\boldsymbol{b_{1}}, \boldsymbol{b_{2}},..., \boldsymbol{b_{n}})} và B~=(b1~,b2~,...,bn~){\tilde{B} = (\boldsymbol{\tilde{b_{1}}}, \boldsymbol{\tilde{b_{2}}},..., \boldsymbol{\tilde{b_{n}}})} của V{V}.

C=(c1,c2,...,cn){C = (\boldsymbol{c_{1}}, \boldsymbol{c_{2}},..., \boldsymbol{c_{n}})} và C~=(c1~,c2~,...,cn~){\tilde{C} = (\boldsymbol{\tilde{c_{1}}}, \boldsymbol{\tilde{c_{2}}},..., \boldsymbol{\tilde{c_{n}}})} của W{W}.

AΦ∈Rm×n{\boldsymbol{A_{\Phi}} \in \Bbb R^{m \times n}} là ma trận biến đổi của ánh xạ tuyến tính Φ:V→W{\Phi: V \to W} ứng với cơ sở B{B} và C{C}.

AΦ~∈Rm×n{\boldsymbol{\tilde{A_{\Phi}}} \in \Bbb R^{m \times n}} là ma trận biến đổi của ánh xạ tuyến tính Φ:V→W{\Phi: V \to W} ứng với cơ sở B~{\tilde{B}} và C~{\tilde{C}}.

Bằng việc chuyển đổi cơ sở và các biểu diễn của các véc-tơ, các ma trận biến đổi ứng với các cơ sở mới có thể ở dạng rất đơn giản và dễ dàng thực hiện các bước tính toán trung gian.

Với 2 ma trận biến đổi như ở phần trên, tương quan giữa chúng được biểu diễn như sau

AΦ~=T−1AϕS{\boldsymbol{\tilde{A_{\Phi}}} = \boldsymbol{T^{-1}}\boldsymbol{A_{\phi}}\boldsymbol{S}}

Với S∈Rn×n{\boldsymbol{S} \in \Bbb R^{n \times n}} là ma trận biến đổi của phép ánh xạ đơn vị liên kết tọa độ của véc-tơ ứng với cơ sở B~{\tilde{B}} lên tọa độ ứng với cơ sở B{B}. Với T∈Rm×m{\boldsymbol{T} \in \Bbb R^{m \times m}} là ma trận biến đổi của phép ánh xạ đơn vị liên kết tọa độ của véc-tơ ứng với cơ sở C~{\tilde{C}} lên tọa độ ứng với cơ sở C{C}. (Phần chứng minh chi tiết bạn có thể truy cập link sách mà mình để ở trên)

Như vậy, một phép biến đổi cơ sở trong V{V} (cơ sở B{B} được thay thế bằng cơ sở B~{\tilde{B}}) và W{W} (cơ sở C{C} được thay thế bằng cơ sở C~{\tilde{C}}), ma trận biến đổi AΦ{\boldsymbol{A_{\Phi}}} của phép ánh xạ tuyến tính Φ:V→W{\Phi: V \to W} được thay thế bởi ma trận biến đổi tương đương AΦ~{\boldsymbol{\tilde{A_{\Phi}}}}.

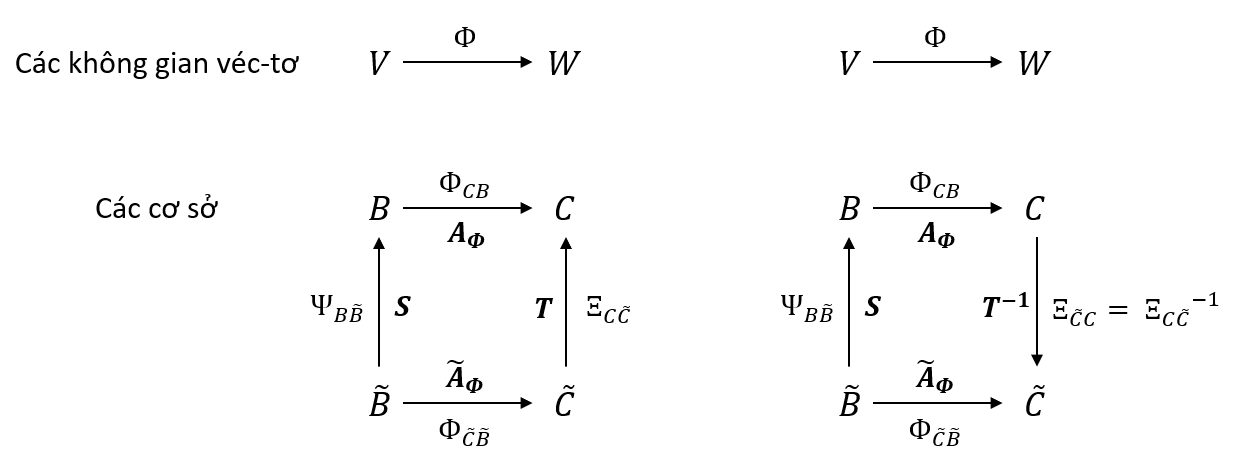
Basis Change

Nhìn vào hình trên, ta thấy được

ΦB~C~=ΞC~C∘ΦCB∘ψBB~=ΞCC~−1∘ΦCB∘ψBB~{\Phi_{\tilde{B}\tilde{C}} = \Xi_{\tilde{C}C} \circ \Phi_{CB} \circ \psi_{B\tilde{B}} = \Xi_{C\tilde{C}}^{-1} \circ \Phi_{CB} \circ \psi_{B\tilde{B}}}

Với ψBB~=idV{\psi_{B\tilde{B}} = id_{V}} và ΞC~C=idW{\Xi_{\tilde{C}C} = id_{W}} là các ánh xạ đơn vị ánh xạ các véc-tơ lên chính chúng, nhưng mà ứng với các cơ sở khác nhau.

Sau đây, mình đưa ra 2 khái niệm sau về ma trận

  • Tương đương: 2 ma trận A,A~∈Rm×n{\boldsymbol{A}, \boldsymbol{\tilde{A}} \in \Bbb R^{m \times n}} là tương đương nếu tồn tại hai ma trận khả ngịch S∈Rn×n{\boldsymbol{S} \in \Bbb R^{n \times n}} và T∈Rm×m{\boldsymbol{T} \in \Bbb R^{m \times m}} thỏa mãn A~=T−1AS{\boldsymbol{\tilde{A}} = \boldsymbol{T}^{-1}\boldsymbol{A}\boldsymbol{S}}.
  • Đồng dạng: 2 ma trận A,A~∈Rn×n{\boldsymbol{A}, \boldsymbol{\tilde{A}} \in \Bbb R^{n \times n}} là đồng dạng nếu tồn tại ma trận khả ngịch S∈Rn×n{\boldsymbol{S} \in \Bbb R^{n \times n}} thỏa mãn A~=S−1AS{\boldsymbol{\tilde{A}} = \boldsymbol{S}^{-1}\boldsymbol{A}\boldsymbol{S}}.

Cuối cùng, xét các không gian véc-tơ V,W,X{V, W, X}. Các ánh xạ tuyến tính Φ:V→W{\Phi: V \to W} với ma trận biến đổi là AΦ{\boldsymbol{A_{\Phi}}} và ψ:W→X{\psi: W \to X} với ma trận biến đổi là Aψ{\boldsymbol{A_{\psi}}}, ánh xạ ψ∘Φ:V→X{\psi \circ \Phi: V \to X} cũng là ánh xạ tuyến tính với ma trận biến đổi là Aψ∘Φ=AψAΦ{\boldsymbol{A_{\psi \circ \Phi}} = \boldsymbol{A_{\psi}}\boldsymbol{A_{\Phi}}}. Chứng minh như sau

AΦ:B→C;AΦ~:B~→C~;S:B~→B;T:C~→C{ \boldsymbol{A_{\Phi}}: B \to C; \boldsymbol{\tilde{A_{\Phi}}}: \tilde{B} \to \tilde{C}; \boldsymbol{S}: \tilde{B} \to B; \boldsymbol{T}: \tilde{C} \to C }

⇒B~→C~=B~→B→C→C~{ \Rightarrow \tilde{B} \to \tilde{C} = \tilde{B} \to B \to C \to \tilde{C} }

⇒AΦ~=T−1AΦS{ \Rightarrow \boldsymbol{\tilde{A_{\Phi}}} = \boldsymbol{T}^{-1}\boldsymbol{A_{\Phi}}\boldsymbol{S} }

Bởi vì

x⟼Sx⟼AΦ(Sx)⟼T−1(AΦ(Sx))=AΦ~(x){ \boldsymbol{x} \longmapsto \boldsymbol{Sx} \longmapsto \boldsymbol{A_{\Phi}}(\boldsymbol{Sx}) \longmapsto \boldsymbol{T}^{-1}(\boldsymbol{A_{\Phi}}(\boldsymbol{Sx})) = \boldsymbol{\tilde{A_{\Phi}}}(\boldsymbol{x}) }

Image và kernel​

Cho Φ:V→W{\Phi: V \to W}, chúng ta định nghĩa kernel/null space là

Ker(Φ):=Φ−1(0W)=v∈V:Φ(v)=0W{Ker(\Phi) := \Phi^{-1}(\boldsymbol{0_{W}}) = \\{\boldsymbol{v} \in V: \Phi(\boldsymbol{v}) = \boldsymbol{0_{W}}\\}}.

Và image/range là

Im(Φ):=Φ(V)=w∈W∣∃v∈V:Φ(v)=w{Im(\Phi) := \Phi(V) = \\{\boldsymbol{w} \in W | \exists \boldsymbol{v} \in V: \Phi(\boldsymbol{v}) = \boldsymbol{w}\\}}.

Chúng ta gọi V và W lần lượt là các domain và codomain của Φ{\Phi}. Một vài tính chất được rút ra như sau

  • Kernel không bao giờ là tập rỗng khi mà ta luôn có Φ(0V)=0W{\Phi({\boldsymbol{0_{V}}}) = \boldsymbol{0_{W}}}.
  • Im(Φ)⊆W{Im(\Phi) \subseteq W } là một không gian véc-tơ con của W{W} và Ker(Φ)⊆V{Ker(\Phi) \subseteq V} là một không gian véc-tơ con của V{V}.
  • Φ{\Phi} là một đơn ánh khi và chỉ khi Ker(Φ)=0{Ker(\Phi) = \\{\boldsymbol{0}\\}}.

Cho một ma trận A∈Rm×n{\boldsymbol{A} \in \Bbb R^{m \times n}} là một ánh xạ tuyến tính Φ:Rn→Rm,x⟼Ax{\Phi: \Bbb R^{n} \to \Bbb R^{m}, \boldsymbol{x} \longmapsto \boldsymbol{Ax}}. Với A=[a1,a2,...,an]{\boldsymbol{A} = [\boldsymbol{a_{1}}, \boldsymbol{a_{2}},..., \boldsymbol{a_{n}}]}

Im(Φ)=Ax:x∈Rn=∑i=1nxiai:x1,...,xn∈R=span[a1,a2,...,an]⊆Rm{ Im(\Phi) = \\{\boldsymbol{Ax}: x \in \Bbb R^{n}\\} = \\{\sum_{i=1}^{n}x_{i}\boldsymbol{a_{i}}: x_{1},..., x_{n} \in \Bbb R\\} = span[\boldsymbol{a_{1}}, \boldsymbol{a_{2}},..., \boldsymbol{a_{n}}] \subseteq \Bbb R^{m} }.

Image ở đây sẽ là span của các cột trong ma trận A{A}, và cũng được gọi là column space. Bởi vậy, column space là một không gian véc-tơ con của Rm{\Bbb R^{m}}.

  • rk(A{A}) ={=} dim(Im(Φ){Im(\Phi)}).
  • Kernel Ker(Φ){Ker(\Phi)} là nghiệm chung của hệ phương trình tuyến tính Ax=0{\boldsymbol{Ax} = \boldsymbol{0}} và bao gồm tất cả tổ hợp tuyến tính của các phần tử thuộc Rn{\Bbb R^{n}} mà cho ra kết quả 0∈Rm{\boldsymbol{0} \in \Bbb R^{m}}.
  • Kernel là một không gian véc-tơ con của Rn{\Bbb R^{n}} tại đó n{n} là chiều rộng của ma trận.
  • Kernel tập trung vào các mối quan hệ của các véc-tơ cột.

Với các không gian véc-tơ V,W{V, W} và một ánh xạ tuyến tính Φ:V→W{\Phi: V \to W}

dim(Ker(Φ){Ker(\Phi)}) + dim(Im(Φ){Im(\Phi)}) = dim(V{V})

  • Nếu dim(Im(Φ){Im(\Phi)}) < dim(V{V}) thì Ker(Φ){Ker(\Phi)} là một tập không tầm thường, nó sẽ gồm véc-tơ 0V{0_{V}} và các véc-tơ khác nữa.
  • Nếu AΦ{\boldsymbol{A_{\Phi}}} và dim(Im(Φ){Im(\Phi)}) < dim(V{V}), thì AΦx=0{\boldsymbol{A_{\Phi}x} = 0} có vô số nghiệm.
  • Nếu dim(V{V}) = dim(W{W}) thì Φ{\Phi} là đơn ánh, toàn ánh, song ánh, Im(Φ)⊆W{Im(\Phi) \subseteq W}.

Không gian véc-tơ Affine​

Không gian véc-tơ Affine con​

Với V là một không gian véc-tơ, x0∈V{\boldsymbol{x_{0}} \in V} và U⊆V{U \subseteq V} là một không gian véc-tơ. Nếu tập con

L=x0+U:=x0+u:u∈U=v∈V∣∃u∈U:v=x0+u⊆V{ L = \boldsymbol{x_{0}} + U := \\{\boldsymbol{x_{0}} + \boldsymbol{u}: \boldsymbol{u} \in U\\} = \\{\boldsymbol{v} \in V | \exists \boldsymbol{u} \in U: \boldsymbol{v} = \boldsymbol{x_{0}} + \boldsymbol{u}\\} \subseteq V }

được gọi là một không gian véc-tơ Affine con. U{U} được gọi là không gian hướng và x0{\boldsymbol{x_{0}}} được gọi là support point.

  • Định nghĩa của không gian véc-tơ Affine sẽ không chứa 0{0} nếu x0∉U{\boldsymbol{x_{0}} \notin U}. Vì thế mà không gian véc-tơ Affine không phải là một không gian véc-tơ con của V{V} với x0∉U{\boldsymbol{x_{0}} \notin U}.

Cho 2 không gian véc-tơ Affine L=x0+U{L = \boldsymbol{x_{0}} + U} và L~=x0~+U~{\tilde{L} = \boldsymbol{\tilde{x_{0}}} + \tilde{U}} của không gian véc-tơ V{V}. L∈L~{L \in \tilde{L}} khi và chỉ khi U∈U~{U \in \tilde{U}} và x0−x0~∈U~{\boldsymbol{x_{0}} - \boldsymbol{\tilde{x_{0}}} \in \tilde{U}}.

Cho một không gian véc-tơ Affine k{k} chiều L=x0+U{L = \boldsymbol{x_{0}} + U} của V{V}. Nếu (b1,b2,...,bk){(\boldsymbol{b_{1}}, \boldsymbol{b_{2}},..., \boldsymbol{b_{k}})} là một cơ sở của U{U}, thì mỗi x∈L{\boldsymbol{x} \in L} có thể được biểu diễn duy nhất dưới dạng

x=x0+λ1b1+λ2b2+...+λkbk{ \boldsymbol{x} = \boldsymbol{x_{0}} + \lambda_{1}\boldsymbol{b_{1}} + \lambda_{2}\boldsymbol{b_{2}} +...+ \lambda_{k}\boldsymbol{b_{k}} }

Biểu diễn này được gọi là phương trình tham số của L{L} với các véc-tơ hướng b1,b2,...,bk{\boldsymbol{b_{1}}, \boldsymbol{b_{2}},..., \boldsymbol{b_{k}}} và các tham số λ1,λ2,...,λk{\lambda_{1}, \lambda_{2},..., \lambda_{k}}.

Ánh xạ Affine​

Với các không gian véc-tơ V,W{V, W}, một ánh xạ tuyến tính Φ:V→W{\Phi: V \to W} và λ∈W{\lambda \in W}, các ánh xạ

ϕ:V→Wx⟼λ+Φ(x){\phi: V \to W \\\\ \boldsymbol{x} \longmapsto \boldsymbol{\lambda} + \Phi(\boldsymbol{x})}

là một ánh xạ Affine từ V{V} đến W{W}. Véc-tơ λ{\boldsymbol{\lambda}} được gọi là véc-tơ dịch của ϕ{\phi}.

  • Mỗi ánh xạ Affine ϕ:V→W{\phi: V \to W} là một sự kết hợp của một ánh xạ tuyến tính Φ:V→W{\Phi: V \to W} và một phép dịch τ:W→W{\tau: W \to W} trong W{W}, với ϕ=τ∘Φ{\phi = \tau \circ \Phi}. Ánh xạ Φ{\Phi} và τ{\tau} là duy nhất.
  • Sự kết hợp ϕ′∘ϕ{\phi^{'} \circ \phi} của ánh xạ Affine ϕ:V→W,ϕ′:W→X{\phi: V \to W, \phi^{'}: W \to X} cũng là một ánh xạ Affine.
  • Các ánh xạ Affine bảo toàn cấu trúc hình học. Nó cũng bảo toàn số chiều và tính chất song song.